Бэкапы глазами SOC: от домашнего NAS до охоты на тех, кто мешает восстановиться
Synology дома, ransomware против резервных копий и практические сценарии детектирования для SOC: Veeam, Windows, AWS Backup, SIEM и Threat Hunting.
Бэкапы глазами SOC: от домашнего NAS до охоты на тех, кто мешает восстановиться
Личные заметки про Synology, подорожавшие диски и то, почему события из систем резервного копирования стоит тащить в мониторинг безопасности.
Ну что, посоны, как там ваши бэкапы себя чувствуют? 😏
Задания зелёные? Репозитории доступны? На дашборде всё красиво? Отлично. А восстанавливаться из этого добра пробовали? Или договорились не трогать, пока работает?
Есть старая шутка: люди делятся на два типа: те, кто делает бэкапы, и те, кто УЖЕ делает бэкапы. Мне кажется, есть ещё третий тип: у них резервные копии вроде бы есть, но проверять их некогда. Самый спокойный тип людей. До определённого момента.
Я тут задумался о бэкапах сразу с двух сторон: как обычный владелец домашнего NAS и как человек, который смотрит на инфраструктуру глазами SOC. Без откровений из серии «как правильно жить». Просто мысли на актуальную тему, немного личной истории и практики мониторинга: что можно увидеть до того, как кто-нибудь решит оставить компанию без вариантов восстановления.
«Не делай себе голову, купи Synology»
Года два назад я загорелся идеей завести собственный NAS. Хотелось своего хранилища: складывать туда всякое полезное, не зависеть целиком от облаков, делать резервные копии. Ну и, чего уж скрывать, возможность поковырять ещё одну железку тоже грела душу.
Изначально план был вполне айтишный: собрать всё самому, поставить FreeNAS, разобраться, настроить как хочется. Казалось, что так будет и интереснее, и гибче. Может, даже дешевле. Правда, вместе с гибкостью я получал ещё одну систему, которую придётся обслуживать после работы.
Как-то я попал на митап журнала «Хакер». После него мы сидели в баре, болтали с парнем из PT (Positive Technologies). Кажется, он там занимался DevOps. Разговор, как это обычно бывает, куда-то свернул и дошёл до домашних NAS.
Я поделился планом собрать свой. А он говорит: «Я тоже хотел. Даже собирал. И знаешь что? Не делай себе голову, купи готовый Synology. Это как айфон в мире NAS».
Я, конечно, не побежал сразу в магазин. Ещё долго смотрел обзоры, сравнивал готовые устройства с самосбором, прикидывал, что мне действительно нужно. Но эта фраза засела. В итоге купил Synology DS923+ и не пожалел. Устройство просто делает то, ради чего я его покупал, а время можно потратить на что-нибудь другое.
Это не реклама. Но если Synology вдруг захочет занести денег за этот абзац, я, так и быть, выслушаю предложение. Хе-хе.
💸 А вот на дисках я решил сэкономить. Зря
С самим NAS определиться было проще, чем с накопителями. Сначала смотришь на цену коробочки, потом понимаешь, что диски к ней покупаются отдельно. Потом считаешь стоимость нормальных HDD, вздыхаешь и начинаешь торговаться сам с собой: «Ну пока хватит, потом докуплю».
В мае 2025-го я взял два 8-ТБ Toshiba MG10 по 17 700 ₽ за штуку. Всего 35 400 ₽. А в октябре 2026-го увидел ту же модель в том же магазине за 57 500 ₽ за штуку. Это в 3,25 раза дороже, или на 39 800 ₽ больше за диск. Это цена в одном конкретном магазине, за весь рынок не поручусь. Но смотреть всё равно больно. Особенно когда вспоминаешь собственное «да потом докуплю, куда они денутся». Спойлер: никуда не делись. Просто подорожали.
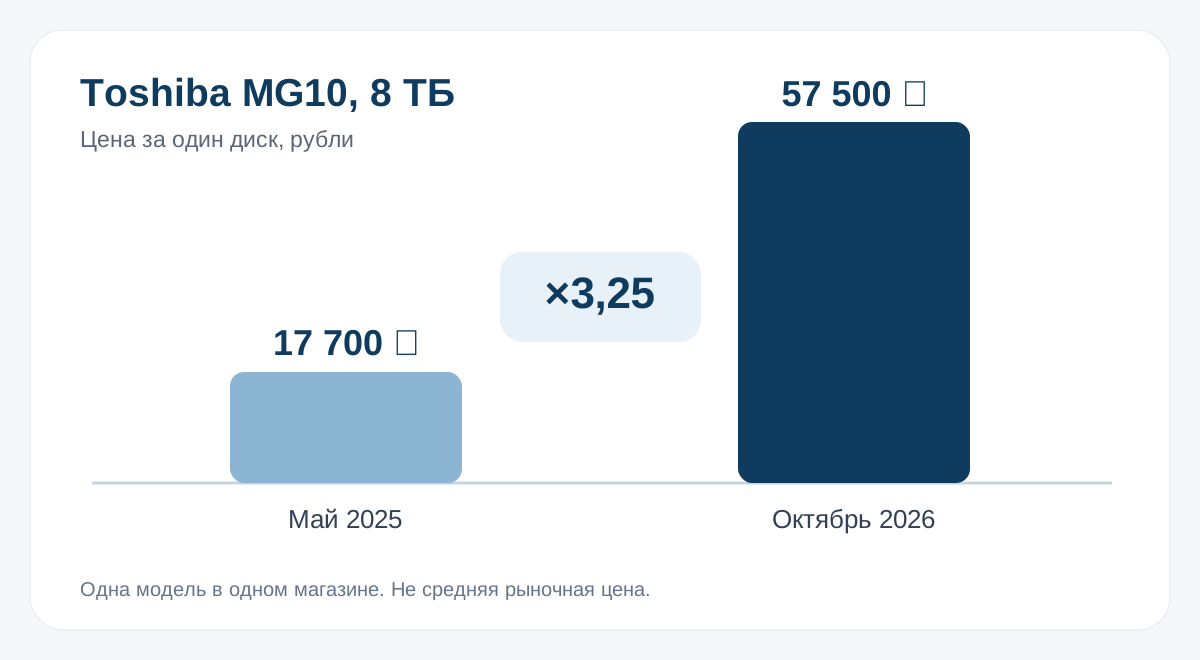
Теперь думаю, почему я тогда не купил больше дисков. Классика.
На этой мысли я и зацепился за тему статьи. Где вообще лежат мои данные? Что из них получится вернуть? Что должно остаться рабочим для восстановления? Вопросы домашние, но в работе SOC к ним постоянно возвращаешься.
Что у меня вообще настроено дома
На NAS в своё время настроил Cloud Sync с Яндекс Диском: дополнительно забираю данные из облака к себе. Ещё использую Acronis True Image, который складывает резервные копии на NAS.
И тут, конечно, самое время с умным видом рассказать о регулярных проверках восстановления.
Кстати, пойду-ка проверю, когда мой Acronis в последний раз вообще делал бэкап. 😅
В моём случае Cloud Sync и Acronis решают разные задачи. И тут стоит отделить понятия, которые периодически смешивают даже в рабочих обсуждениях:
| Механизм | Что даёт | Чего сам по себе не гарантирует |
|---|---|---|
| RAID | Пережить отказ диска в рамках возможностей выбранной конфигурации | Возврат удалённых или зашифрованных данных |
| Синхронизация | Второй экземпляр актуальных файлов в другой точке | Сохранение старых версий и защиту от синхронизации нежелательных изменений |
| Снимки (snapshots) | Откат к состоянию на определённый момент | Выживание при потере самого хранилища или его полном компрометировании |
| Резервная копия | Восстановление данных из сохранённой точки во времени | Работоспособность восстановления без реальной проверки |
У Cloud Sync есть настройка, позволяющая не удалять файлы в папке назначения, если они удалены в источнике. Но направление синхронизации, её параметры и наличие версий надо проверять отдельно: просто надпись «синхронизировано» не заменяет стратегию восстановления.
И да, я пока не использую Snapshot Replication и Hyper Backup. Так что идеальную домашнюю схему изображать не буду. В интернете и без меня хватает людей, у которых всё уже настроено идеально, осталось только рассказать об этом остальным.
📊 Пара цифр, от которых становится неуютно
Вендорские исследования стоит читать с поправкой на выборку и методологию. Но несколько цифр вполне заслуживают внимания.
Veeam, Ransomware Trends 2025. В исследовании 1 300 организаций сообщается, что у 89% респондентов атакующие нацеливались на репозитории резервного копирования. В среднем 34% репозиториев оказались изменены или удалены. Только 44% организаций включили проверку резервных копий и частоту их создания в ransomware-playbook, а 32% использовали immutable-репозитории или аналогичные сервисы. Это ответы участников исследования, а не статистика «89% всех компаний мира».
Veeam, Data Trust & Resilience Report 2026. Среди более чем 900 опрошенных руководителей в области ИТ, безопасности и рисков 90% выразили уверенность, что смогут уложиться в целевые сроки восстановления (RTO). При этом среди переживших ransomware только 28% заявили о полном восстановлении затронутых данных. Это разные показатели и группы внутри исследования, их нельзя механически сравнивать как результат одного контрольного эксперимента. Но разрыв между ожиданиями и реальными результатами очень показательный.
Меня здесь интересует даже не конкретный процент. Вопрос в другом: откуда берётся уверенность в восстановлении? Из зелёного статуса задания? Из отчёта, что где-то хранится N терабайт копий? Или из последнего испытания, когда критичную систему реально подняли в требуемое время? Потому что зелёная галочка на дашборде, конечно, успокаивает. Особенно пока ничего не случилось.
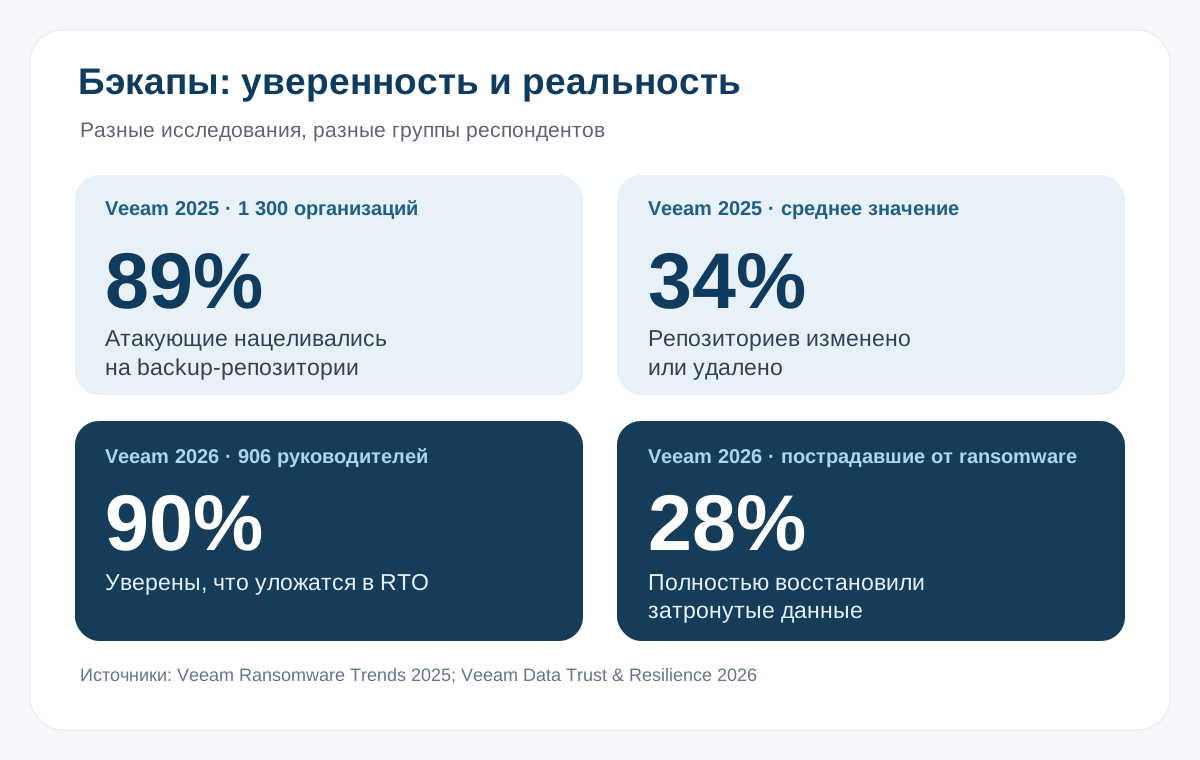
Показатели 2025 и 2026 годов относятся к разным группам опрошенных. Сравнивать их как одну выборку нельзя.
🎯 Почему атакующим вообще интересны бэкапы
Логика достаточно простая. Если компания может быстро восстановить данные, у вымогателя меньше рычагов давления. Поэтому перед шифрованием атакующие нередко пытаются уничтожить точки восстановления, отключить резервное копирование, изменить политики хранения или добраться до самой платформы бэкапов.
В MITRE ATT&CK для таких действий есть T1490 (Inhibit System Recovery). В описании техники упоминаются удаление теневых копий Windows, вмешательство в резервное копирование и уничтожение снимков виртуальных машин. У атакующих вполне конкретная цель: оставить защитников без вариантов отката. Логика примерно такая: сначала убрать пожарный выход, а уже потом устраивать пожар.
Есть и вполне приземлённые кейсы. В обзоре Google Threat Intelligence Group / Mandiant за март 2026 года описано расследование, в котором атакующий получил доступ к серверу Commvault и удалил тома резервного копирования vCenter перед шифрованием. В другом случае злоумышленник загрузил Rclone и Linux-вариант INC ransomware на NAS, сначала вывел данные, а затем запустил шифрование. Это уже не теоретические слайды про ransomware, а действия, увиденные в расследованиях.
Получается неприятная последовательность: сначала чужой человек добирается до средств восстановления, потом ломает возможность отката и только затем делает основную грязную работу. Не всегда именно в таком порядке, но суть понятна.
И вот на действиях до шифрования у SOC иногда появляется шанс вмешаться.
Что здесь вообще делать SOC
У резервного копирования есть свои администраторы. Владельцы бизнес-сервисов определяют требования к RPO/RTO. SOC со своей стороны должен видеть подозрительную активность вокруг инфраструктуры восстановления и уметь оценить её в контексте инцидента.
Я бы разделил работу на три направления.
Первое: мониторинг атак на средства восстановления. Административные входы, повышение привилегий, новые учётки, изменение политик, отключение задач, удаление точек восстановления, операции с репозиториями, подозрительные действия на гипервизорах. Эта телеметрия полезна аналитикам. У администраторов backup-системы и SOC будут разные вопросы к одним и тем же событиям.
Второе: контроль потери способности восстановиться. Например, резервная копия критичной системы не создавалась дольше допустимого RPO или провалился плановый тест восстановления. Это не обязательно кибератака и не обязательно P1 для SOC. Не нужно превращать каждый failed job в инцидент века. Но такие сигналы должны попадать к ответственным, а SOC полезно иметь к ним доступ при расследовании. Иначе можно красиво остановить шифровальщик, а потом выяснить, что последняя пригодная копия была месяц назад.
Третье: понимание границ восстановления при инциденте. Когда была первая компрометация? Какие учётные записи использовал атакующий? Мог ли он менять задания бэкапа? С какого момента точки восстановления уже нельзя считать доверенными? Без этих вопросов восстановление рискует превратиться в повторное заражение.
Что именно детектировать
| Сценарий | На что смотреть | Где искать события |
|---|---|---|
| Удаление средств восстановления Windows | vssadmin, wbadmin, diskshadow, bcdedit с опасными аргументами | Sysmon, Security 4688, EDR |
| Вмешательство в backup-платформу | Удаление restore point, задания, изменение retention и состава резервируемых объектов | Audit / syslog / API ПО резервного копирования |
| Захват административного доступа | Новый администратор, необычный источник входа, подозрительная привилегированная сессия | AD, IAM, PAM, VPN, EDR, журналы платформы |
| Удаление cloud recovery points | Необычные API-вызовы удаления, изменение политик доступа или защиты | CloudTrail, Azure Activity Logs, облачный backup-аудит |
| Повреждение цепочки восстановления | Накопление неуспешных заданий, потеря репозитория, неуспешный тест восстановления | Backup monitoring, инфраструктурный мониторинг, ITSM |
Важный нюанс: snapshot виртуальной машины может оказаться неподходящей заменой полноценному бэкапу. Кроме того, удаление репозитория из конфигурации продукта ещё не доказывает уничтожения файлов копий. При разработке детектов такие детали имеют значение.
Пример правила №1: попытка удалить средства восстановления Windows
Ниже упрощённый пример Sigma, который стоит адаптировать под свой EDR/SIEM. Он ловит характерные команды, но не доказывает, что машина подверглась ransomware-атаке.
title: Suspicious Windows Recovery Destruction
status: experimental
description: Detects native tools used to remove Windows recovery data
logsource:
  category: process_creation
  product: windows
detection:
  vss_image:
    Image|endswith: '\vssadmin.exe'
  vss_args:
    CommandLine|contains|all:
      - 'delete'
      - 'shadows'
  wb_image:
    Image|endswith: '\wbadmin.exe'
  wb_args:
    CommandLine|contains|all:
      - 'delete'
      - 'catalog'
  condition: (vss_image and vss_args) or (wb_image and wb_args)
falsepositives:
  - Authorized maintenance
  - Backup cleanup operations
level: high
tags:
  - attack.impact
  - attack.t1490
Подойдут Sysmon Event ID 1 или Windows Security 4688 при включённом логировании командной строки. Дальше нужна нормальная аналитика: кто запустил команду, на каких хостах, через какой процесс, не было ли до этого подозрительного доступа и не началась ли такая же активность массово. Алерт «запустился vssadmin.exe» без окружения быстро превратится в очередное уведомление, которое все научатся закрывать не читая.
Пример правила №2: удаление restore points и изменение настроек Veeam
В Veeam Backup & Replication 13 есть полезные события для SIEM (в других версиях состав и формат стоит проверить отдельно):
| Event ID | Событие |
|---|---|
10050 | Restore Point Deleted |
23050 | Job Settings Updated |
23090 | Job Deleted |
28100 | Backup Repository Settings Updated |
28200 | Backup Repository Deleted |
Важно: у некоторых операций удаления есть штатные причины, например выполнение retention. Одного Event ID без пользователя и контекста недостаточно. Я бы начал с корреляции: несколько опасных изменений за короткое время плюс необычная административная сессия, новый источник подключения или отсутствие согласованного изменения. А одиночное удаление задания в рамках штатного обслуживания не превращал бы автоматически в Critical.
И ещё раз: 28200 фиксирует удаление объекта репозитория из конфигурации Veeam. Состояние файлов на хранилище нужно проверять отдельно.
Пример правила №3: облачные резервные копии
В AWS Backup интересны, например, события CloudTrail с операциями DeleteRecoveryPoint, DeleteBackupPlan, DeleteBackupVault и изменением политики доступа через PutBackupVaultAccessPolicy.
Вместо реакции на каждый вызов по отдельности я бы проверял сочетания: редкая для роли операция, нетипичный IP/сессия, массовость, обращение к критичным хранилищам и последовательность «изменили политику → начали удалять recovery points». Успешность вызова важна, но неудачная попытка тоже может быть следом атаки, которую остановили права или защита хранилища.
🖥️ Сценарий из привычной инфраструктуры: Windows, AD и Veeam
Начнём с более знакомой многим российским компаниям схемы: Windows-домен, сервер Veeam Backup & Replication, отдельные репозитории, SIEM и какое-нибудь EDR на хостах. Кстати, в таких сетях бывает весело: у backup-сервера полномочий зачастую больше, чем хотелось бы.
Сценарий учебный. Никакой реальный инцидент за этим описанием не стоит. Имена систем, адреса, время и действия вымышлены, а номера событий взяты из документации Veeam 13 и Windows.
Допустим, кто-то завладел учёткой CORP\backup.admin и смог подключиться к vbr01.corp.local. Дальше в журналах начинает складываться такая история:
| Время (МСК) | Источник и событие | Что видит аналитик |
|---|---|---|
| 09:41 | Windows Security 4624, LogonType=10 | Успешный RDP-вход CORP\backup.admin на vbr01 с 10.20.30.44. Для этого администратора источник новый |
| 09:45 | Veeam 23050, Job Settings Updated | Изменено задание PROD-VMs. В ChangesXML и истории настроек ищем, что именно поменялось. В нашем сценарии выясняется, что критичная VM исключена из задания |
| 09:48 | Veeam 23090, Job Deleted | Та же учётка удаляет другое задание, PROD-DB. В событии есть UserName, JobName и VbrHostName |
| 09:50 | Veeam 10050, Restore Point Deleted | Удалена точка восстановления PROD-DB01. Аналитик проверяет VmName, RepositoryID и UserFullInfo |
| 09:53 | SIEM / SOAR | Корреляция связывает вход и операции за 15 минут. Для критичной инфраструктуры это повод открыть инцидент с высоким приоритетом |
Что именно объединяем в правило:
Объект: backup-сервер из списка критичных узлов
Условие A: Windows Security 4624, LogonType = 10,
           вход привилегированного пользователя с нового источника
Условие B: Veeam instanceId = 23050 / 23090 / 28100 / 28200
Условие C: Veeam instanceId = 10050
Окно: 15 минут
Связь: нормализованная учётка + backup-сервер
Приоритет: High при A + B;
           Critical при A + B + C или подтверждённом удалении
           критичных копий, с учётом действующих мер защиты
Здесь сразу несколько технических нюансов. В Veeam идентификатор события в syslog может лежать в instanceId. У событий 23050 и 23090 есть поле UserName, а у 10050 подробности об инициаторе находятся в UserFullInfo. При сведении в SIEM их придётся привести к общему полю actor. Для корреляции по хосту используем VbrHostName и имя компьютера из Windows Security. И помним про терминальные серверы, PAM и jump host: новый IP сам по себе ещё не компрометация.
Что делает SOC после срабатывания? Проверяет согласованные работы, связывается с владельцем учётки по независимому каналу, поднимает историю сессии и изменения Veeam, уточняет реальное состояние точек восстановления. Если доступ выглядит чужим, совместно с администраторами ограничивает сессию и полномочия, проверяет смежные серверы и сохраняет журналы. Параллельно backup-команда оценивает возможность восстановления и состояние защищённых копий.
Ещё одна неприятная деталь: изменение задания с 23050 само по себе не раскрывает последствия. Смотрим ChangesXML, текущую конфигурацию и историю изменений. А 10050 подтверждает факт удаления точки, но не отвечает на вопрос, сколько доступных копий осталось. Для этого нужен отдельный запрос к инвентаризации бэкапов. Иначе высок риск красиво расследовать удаление одной точки, пока остальные сто таких же спокойно лежат на месте. Или наоборот. 😬
В продуктивной корреляции я бы предусмотрел исключения для согласованных работ. На удаление критичных точек нужна также отдельная срочная реакция, без ожидания всей цепочки. А ещё проверил бы, какие события реально доступны в используемой версии Veeam и доходят ли они до SIEM без потери полей.
Полезные первоисточники: Windows Security 4624, Veeam 23050, Veeam 23090, Veeam 10050.
☁️ Облачный сценарий: 12 минут от странного входа до действий SOC
Для контраста посмотрим ещё один вариант, уже с AWS Backup. Здесь есть цепочка событий, которую можно собрать в SIEM: вход, изменение настроек, попытки удаления и реакция команды.
Важно: ниже синтетический учебный кейс, а не описание реального инцидента. Время, учётная запись, IP и объекты придуманы. Названия API и структура ключевых полей основаны на AWS CloudTrail / AWS Backup. В реальной инфраструктуре набор полей, средства входа и результат блокировки будут зависеть от конфигурации.
Предположим, есть AWS-аккаунт с критичными сервисами и настроенным AWS Backup. Атакующий получил доступ к административной IAM-учётке. Это для простоты примера: при входе через Identity Center или федерацию цепочку нужно собирать с учётом SSO и временных ролей.
| Время (UTC) | Событие | Что видим в логах | Что это значит для SOC |
|---|---|---|---|
| 10:14 | ConsoleLogin | eventSource=signin.amazonaws.com, responseElements.ConsoleLogin=Success, sourceIPAddress=203.0.113.42, additionalEventData.MFAUsed=No | Административный вход без MFA с нового для этой учётки источника. Сам по себе ещё не доказательство компрометации. |
| 10:17 | UpdateBackupPlan | eventSource=backup.amazonaws.com, userIdentity.arn=...:user/backup-admin, идентификатор плана из requestParameters | Изменили план резервного копирования. При сравнении версий выясняется, что retention будущих копий сокращён с 35 до 7 дней. |
| 10:19 | DeleteRecoveryPoint | Тот же субъект и IP, backupVaultName=prod-critical, recoveryPointArn=..., errorCode=AccessDeniedException | Попытка удалить конкретную точку восстановления не удалась из-за отказа в доступе. Это уже сильный сигнал, даже если защита сработала. |
| 10:20 | Ещё две попытки DeleteRecoveryPoint | Другие recoveryPointArn, тот же субъект, аналогичные ошибки | Похоже не на случайный клик, а на последовательную попытку удалить несколько точек. |
| 10:22 | Корреляция в SIEM → инцидент в SOAR | Общая учётка, IP, аккаунт и окно 15 минут | Приоритет Critical для критичной backup-инфраструктуры: возможна целенаправленная атака на способность восстановиться. |
| 10:26 | Начальные действия SOC / IR | Проверка change request, подтверждение владельца учётки, блокировка дальнейших подозрительных действий | Изолируем скомпрометированный доступ совместно с IAM/облаком, сохраняем доказательства, проверяем другие операции атакующего. |
Вот как может выглядеть один укороченный пример CloudTrail-события попытки удаления (служебные поля опущены, значения вымышлены):
{
  "eventTime": "2026-10-12T10:19:06Z",
  "eventSource": "backup.amazonaws.com",
  "eventName": "DeleteRecoveryPoint",
  "userIdentity": {
    "arn": "arn:aws:iam::111122223333:user/backup-admin"
  },
  "sourceIPAddress": "203.0.113.42",
  "requestParameters": {
    "backupVaultName": "prod-critical",
    "recoveryPointArn": "arn:aws:ec2:eu-central-1::snapshot/snap-0123456789abcdef0"
  },
  "errorCode": "AccessDeniedException"
}
Здесь есть пара деталей, которые легко упустить.
Во-первых, изменение UpdateBackupPlan влияет на будущие копии и само по себе не переписывает retention существующих точек. В нашем сценарии снижение retention с 35 до 7 дней относится к будущим копиям. Поэтому опасно, но это не доказательство удаления старых бэкапов.
Во-вторых, DeleteRecoveryPoint с errorCode фиксирует неуспешную попытку. Причина отказа требует проверки. Доступ мог ограничивать IAM, защитная политика или Vault Lock в подходящей конфигурации. Сообщать об уничтожении всех бэкапов по такому событию было бы преждевременно.
Что делает аналитик после такого срабатывания?
- Подтверждает контекст. Смотрит историю учётки и IP, MFA, change management, способ получения сессии, привилегии. Проверяет, действительно ли административные изменения не санкционированы.
- Ограничивает дальнейшие действия атакующего. Совместно с владельцами IAM/облака отзывает или ограничивает скомпрометированный доступ, учитывая активные сессии и риск остановить штатное резервное копирование.
- Оценивает уже нанесённый ущерб. Ищет успешные
DeleteRecoveryPoint, другиеUpdateBackupPlan, изменения vault access policy, удаления планов и заданий, сравнивает доступные точки с учётом/инвентаризацией до атаки. - Проверяет устойчивость восстановления. Вместе с backup-командой подтверждает наличие доступных репозиториев, защищённых копий, действующие настройки retention и отсутствие неожиданных изменений.
- Расширяет расследование. Кто получил учётку и откуда? Какие ещё роли принимались, какие ресурсы трогали, не было ли аналогичных действий в соседних аккаунтах? Сохраняет CloudTrail и артефакты для таймлайна.
Как я бы коррелировал это в SIEM: ConsoleLogin с отклонением от профиля → UpdateBackupPlan от того же субъекта → одна или несколько DeleteRecoveryPoint за 15 минут. Для связи событий нужны userIdentity.arn / principalId, sourceIPAddress, recipientAccountId, eventTime, а также идентификаторы плана и точек восстановления из requestParameters. Для assumed roles понадобятся дополнительные поля сессии, а не тупое сравнение arn как строки.
Сигнал о попытке удаления защищённой копии может быть важнее десятка обычных ошибок задания. В идеальном мире SOC видит эту цепочку до шифрования. В реальной жизни хорошо бы заметить её хотя бы раньше, чем на разборе полётов через неделю.
Для проверки семантики событий: AWS Backup + CloudTrail, UpdateBackupPlan, AWS Backup Vault Lock.
🕵️ А теперь немного хантов
Вот несколько гипотез, которые можно проверить на реальных событиях.
Hunt 1. Кто-нибудь уже ходил на backup-сервер не за бэкапами?
Гипотеза: атакующий получил привилегированный доступ к инфраструктуре резервного копирования, но пока ничего не удалил.
Берём 30-90 дней логов аутентификации и администрирования: новые источники RDP/SSH, необычные сервисные учётки в интерактивных сессиях, появление новых администраторов, доступ из сегментов, из которых обычно не управляют backup-серверами. Затем соединяем это с VPN/PAM/EDR и изменениями конфигурации. На выходе хочется понять, кто и зачем получил доступ, откуда пришёл и был ли у него легитимный путь.
Hunt 2. Не ухудшил ли кто-то восстановление тихо и заранее?
Гипотеза: вместо массового удаления копий атакующий постепенно менял настройки: уменьшал срок хранения, исключал системы из заданий или выключал часть расписаний.
Сравниваем историю конфигураций и backup-аудит за 30-90 дней с согласованными изменениями, перечнем критичных систем и ожидаемой глубиной восстановления. Особенно интересны повторяющиеся небольшие изменения под одной учёткой. Если исторических конфигураций и аудита нет, тоже выяснили полезное: проверить гипотезу нечем. Зато наверняка где-нибудь есть презентация о стопроцентной наблюдаемости.
Hunt 3. А доверяем ли мы точкам, из которых собираемся восстанавливаться?
Гипотеза: часть резервных копий была создана уже после первоначальной компрометации и содержит закрепление атакующего или нежелательные изменения.
Строим таймлайн инцидента, сопоставляем его с точками восстановления, проверяем выбранные образы в изолированной среде, ищем подозрительные задания, новые учётки, механизмы автозапуска и другие следы присутствия. Здесь важно помнить: immutable защищает данные от изменений в заданный период, но чистоту копии не подтверждает.
Можно сколько угодно проверять контрольные суммы. Работоспособность приложения после восстановления придётся подтверждать отдельно.
Зелёный статус задания? Хорошо. Что с восстановлением?
В домашней жизни «сохранить файлы» и «вернуть файлы» часто кажутся одной задачей. В корпоративной среде всё сложнее: восстанавливать придётся сервис с его базой, ключами, конфигурацией, зависимостями и доступами. И желательно уложиться в RTO, потеряв не больше данных, чем допускает RPO.
Поэтому мне нравятся пять простых вопросов:
- Какие критичные системы мы вообще обязаны восстанавливать и откуда?
- Кто, помимо администраторов бэкапа, может удалить или изменить точки восстановления?
- Увидим ли мы эти действия в SOC и сможем ли связать их с конкретной сессией?
- Когда последний раз реально восстанавливали критичную систему, сколько времени это заняло и заработала ли она?
- Что останется доступным для восстановления, если атакующий получит административные права в основной инфраструктуре?
Здесь полезно вспомнить правило 3-2-1, а ещё лучше его расширенный вариант 3-2-1-1-0: три экземпляра данных, разные носители или среды, одна копия вне основной площадки, одна offline/immutable и ноль ошибок, обнаруженных при проверке восстановления. Это ориентир, а не волшебная сертификация. Формула полезная. Но рабочий сервис из неё автоматически не вырастает. Цифры красивые, приложение от этого само не стартует.
Сама CISA в своём руководстве по ransomware отдельно рекомендует держать офлайн-копии критичных данных и регулярно проверять возможность и целостность восстановления. Это как раз та скучная работа, которая оказывается совсем не скучной в день инцидента.
Вместо вывода
Когда я покупал Synology, казалось, что основная задача решена. Вот коробка, вот диски, вот куда складывать данные. Настроил синхронизацию с Яндекс Диском, Acronis делает резервные копии, всё вроде бы хорошо.
Но пока писал эту статью, поймал себя на мысли, что даже дома у меня остаются вопросы. Что именно я смогу восстановить? Сколько времени это займёт? И когда я вообще последний раз проверял, что всё работает? На последний вопрос, кажется, уже пора ответить. 🙃
В корпоративной инфраструктуре всё ещё веселее. Там мало вернуть несколько файлов. Нужно поднять сервисы, базы данных, восстановить конфигурации, доступы, зависимости и желательно уложиться в согласованные RTO/RPO. А если посреди всего этого ещё и кто-то целенаправленно ломал систему резервного копирования, задача становится совсем неприятной.
Проблемы с бэкапами никуда не денутся. Будут заканчиваться диски, падать задания, меняться инфраструктура, появляться новые системы, которые кто-нибудь забудет включить в резервное копирование. Будут ошибаться люди. И будут атакующие, которые прекрасно понимают, насколько болезненно можно ударить по компании, если лишить её возможности восстановиться.
Для SOC здесь тоже хватает работы. Контролировать доступ к инфраструктуре бэкапов, отслеживать опасные изменения, замечать попытки удаления точек восстановления, разбираться в действиях атакующего и помогать определить, каким копиям вообще можно доверять.
И всё-таки главный вопрос остаётся прежним: когда что-нибудь серьёзно сломается, мы действительно сможем восстановиться или только надеемся на это?
Отдельно хочу пожелать сил коллегам из Яндекса. На таких масштабах восстановление сложных систем, думаю, тот ещё квест с огромным количеством технических и организационных нюансов. Со стороны всегда легко рассуждать, как надо было сделать правильно. А вот разгребать последствия, разбираться с зависимостями и возвращать всё в рабочее состояние гораздо сложнее. Держитесь, коллеги!
Ладно, пойду всё-таки проверю, что там с моим Acronis. А то очень удобно писать про чужие бэкапы, пока свои не проверены. 😅
Источники и материалы
- Veeam: 2025 Ransomware Trends and Proactive Strategies (PDF). Статистика атак на репозитории, сценариев восстановления и подготовки.
- Veeam: Data Trust & Resilience Report 2026. Уверенность в RTO и фактическое восстановление после ransomware.
- Google Threat Intelligence Group / Mandiant: Ransomware TTPs in a Shifting Threat Landscape, 2026. Кейсы Commvault и NAS, наблюдения за 2025 год.
- MITRE ATT&CK: T1490 Inhibit System Recovery. Техника и телеметрия для обнаружения.
- Veeam: Event IDs List. Справочник событий аудита Veeam Backup & Replication.
- Synology: Cloud Sync. Режимы синхронизации и поведение при удалении файлов.
- CISA: #StopRansomware Guide. Рекомендации по защищённым копиям и тестам восстановления.
- Veeam: 3-2-1 Backup Rule. Правило 3-2-1-1-0 и проверки восстановления.
- AWS: Logging AWS Backup API calls with CloudTrail. Поля событий и
DeleteRecoveryPoint. - AWS: Updating a backup plan. Особенности изменения retention.
- AWS: Backup Vault Lock. Режимы защиты от удаления.